AIXX Pedia › Fiche modèle › L40S
L40S
Vue d'ensemble OVERVIEW
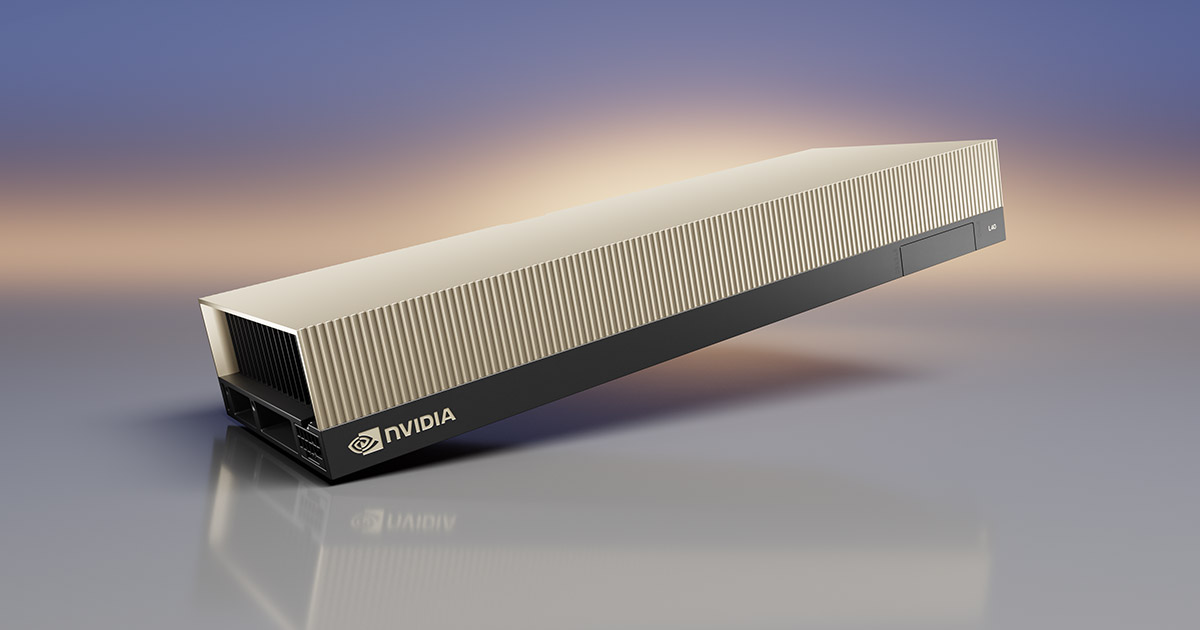
L40S est une GPU datacenter PCIe double slot basée sur l'architecture NVIDIA Ada Lovelace : 48GB GDDR6 ECC, Tensor Core FP8 à 1 466 TFLOPS (chiffres sparse), FP32 91,6 TFLOPS, format passif double slot de 350W — le positionnement officiel est celui d'une « carte double usage, rendu et inférence » : graphisme (3×NVENC/3×NVDEC avec AV1, RT Core 212 TFLOPS) et inférence IA (FP8/INT8) réunis dans une même machine (périmètre des spécifications officielles NVIDIA [1]).
Sa popularité sur le marché des stocks disponibles en Chine tient en une logique simple : 48GB de mémoire + PCIe plug-and-play + aucune ressource NVLink mobilisée — pas de substrat HGX, pas de machine sur mesure : un serveur 2U standard l'accueille et fait tourner de l'inférence quantifiée de niveau 70B ainsi que des pipelines de génération SD/vidéo. C'est l'une des cartes datacenter les plus écoulées côté inférence sur 2024-2026 (d'après l'expérience d'inspection de cette base), et l'une des meilleures solutions pour les activités mixtes « inférence IA + ferme de rendu + transcodage vidéo ».
Trois points à vérifier avant d'acheter une L40S : l'écart de prix avec la L40/L40S (2 TFLOPS de FP32 en plus et 50W de plus, l'écart de prix doit coller), l'adaptation d'alimentation 16-pin (anciens blocs d'alimentation : câble adaptateur conforme requis), le statut Secure Boot et la certification NEBS (un critère déterminant pour les environnements d'entreprise soumis à la conformité, selon les spécifications officielles [1]). Cette fiche ne comporte pas de section marché — le prix réel est soumis au devis du vendeur.
Cas d'usage FIT
AIXX Index (0–100) : estimation pondérée par cette base d'après les spécifications publiques — mémoire 40 % + interconnexion 30 % + écosystème 30 %, pondérations ajustées selon le scénario.
Historique HISTORY
2023 , lancement du L40S : version évoluée du L40 basée sur l'architecture Ada Lovelace — 91,6 TFLOPS FP32 (contre 90,5 pour le L40), même 48 Go de GDDR6 et 3×NVENC/3×NVDEC, positionné sur le double rôle « inférence IA générative + graphisme » (spécifications et gamme officielles NVIDIA [1][2]).
2024 , période de forte demande en inférence : l'explosion des besoins en inférence IA générative fait de la L40S l'une des cartes les plus écoulées côté inférence — pipelines de génération vidéo (SD et équivalents), inférence quantifiée de grands modèles, fermes de transcodage sur trois fronts (recompilation de cette base).
2025-2026 , le statut de référence du marché perdure : la RTX 6000 Ada plus récente (gamme workstation) et la L40 (version d'origine) coexistent, la L40S conserve le sweet spot inférence grâce au FP8 et à la certification NEBS. La gamme successeur d'Ada évoluera selon la feuille de route publique NVIDIA. La réglementation des flux transfrontaliers reste en évolution ; lors des achats, se référer aux politiques des autorités compétentes et à un avis professionnel (d'après les sources publiques).
Spécifications techniques SPECIFICATIONS
| Élément | Spécifications (NVIDIA L40S · chiffres officiels) |
|---|---|
| Architecture GPU | NVIDIA Ada Lovelace |
| Mémoire par carte | 48GB GDDR6 with ECC |
| Bande passante mémoire | 864GB/s |
| Cœurs CUDA / Tensor / RT | 18 176 CUDA · 568 Tensor Core de 4e génération · 142 RT Core de 3e génération (212 TFLOPS en ray tracing) |
| FP32 | 91.6 TFLOPS |
| TF32 Tensor | 183 TFLOPS (366 sparse) |
| BF16 / FP16 Tensor | 362,05 TFLOPS (733 sparse) |
| FP8 / INT8 Tensor | 733 TFLOPS (1 466 sparse) |
| Codecs | 3× NVENC | 3× NVDEC (avec codec AV1) |
| Interface hôte | PCIe Gen4 x16 (64GB/s bidirectionnels) |
| Consommation / alimentation | 350W · 1× 16-pin |
| Format | 4,4"(H) × 10,5"(L) double slot · refroidissement passif |
| Sorties d'affichage | 4× DisplayPort 1.4a |
| Sécurité / certifications | Secure Boot with Root of Trust · NEBS Ready Level 3 |
| MIG / NVLink | Pas de MIG · pas de NVLink (carte PCIe autonome) |
Les spécifications s'appuient sur la capture officielle NVIDIA (base 2026-10 [1], vérifiée point par point avec la fiche technique) ; « sparse » désigne le chiffre officiel marqué d'un astérisque, dense étant la moitié.
Comparatif de la famille L40 L40 FAMILY
| Élément | L40 | L40S (cette fiche) | L40S vs L40 en une phrase |
|---|---|---|---|
| FP32 | 90.5 TFLOPS | 91.6 TFLOPS | FP32 écarté d'un cran, 50W de plus, écart de prix à surveiller — l'inférence prioritaire choisit la L40S, le rendu pur avec budget serré regarde la L40 |
| TDP | 300W | 350W | |
| Mémoire vidéo | 48GB GDDR6 ECC | 48GB GDDR6 ECC |
Le comparatif L40 reprend le même instantané officiel que la fiche technique de cette base ; le gain FP8/INT8 de la L40S vient d'une fréquence et d'une alimentation renforcées (même architecture).
Membres de la famille FAMILY
La famille des cartes datacenter Ada Lovelace se décline par positionnement ; la L40S occupe le créneau double usage inférence/graphisme :
Refroidissement et déploiement COOLING
La L40S est une carte passive double slot de 4,4 pouces de haut × 10,5 pouces de long (350W, 1× alimentation 16-pin) — le refroidissement passif dépend du flux d'air forcé du serveur ; dans une workstation tour classique, prévoir une solution à turbine. Trois points de contrôle au déploiement : Alimentation (interface 16-pin, câble adaptateur conforme pour les anciens blocs, câblage dimensionné pour 350W en pleine charge), slots PCIe Gen4 en lien direct (x16 directement relié au CPU, sans passer par un switch qui bride la bande passante), flux d'air (carte passive double slot sensible au flux d'air du châssis, température d'air entrant à maîtriser à 350W en pleine charge).
Multi-GPU : configurations classiques de 2 à 4 cartes en serveur 2U, 4 cartes à pleine charge représentent 1,4 kW — le dimensionnement du flux d'air est à calculer sérieusement. L'absence de NVLink sur la L40S signifie que le multi-GPU est « calcul en parallèle » et non « domaine d'interconnexion » : parfait pour l'inférence et le rendu, inadapté à l'entraînement.
Compatibilité des modèles MODEL FIT
| Modèle / scénario | Besoins mémoire (estimation FP16) | Repères de déploiement L40S | AIXX Index |
|---|---|---|---|
| Inférence quantifiée niveau 70B | INT4/FP8 environ 35-40GB | sur la limite avec une carte 48GB (KV cache dosé au cordeau), double carte avec vraie marge | 84 |
| Pipelines SD / génération vidéo | FP16 8-24GB | multi-concurrents sur une carte, pipeline fluide accéléré FP8 | 88 |
| Ferme de transcodage vidéo | — (charge codecs) | 3×NVENC/3×NVDEC avec AV1, référence du secteur en densité de transcodage | 90 |
| Entraînement de grands modèles | — | Pas de NVLink / pas de MIG — inadaptée à l'entraînement (voir les fiches A100/H100) | 45 |
Mémoire estimée en poids FP16 ≈ nombre de paramètres × 2 octets (estimation, hors KV cache) ; la stratégie de précision en déploiement quantifié dépend du framework.
Galerie GALLERY
Logiciels et écosystème ECOSYSTEM
| Élément | Exigences / Situation actuelle |
|---|---|
| CUDA | Architecture Ada (compute capability 8.9) — support complet depuis CUDA 11.8, couverture totale par les versions 12.x actuelles |
| Frameworks | PyTorch / TensorFlow / vLLM pleinement supportés (écosystème inférence mature) |
| Stack graphique | Omniverse / DCC pleinement supportés — 4×DP 1.4a en lien direct (rare pour une carte datacenter) |
| Virtualisation | Support vGPU (licences RTX vWS/vPC) — solutions VDI et cloud workstation matures |
| Pilotes | Gamme de drivers datacenter NVIDIA (partagée avec les séries A/H) |
L'écosystème Ada partage la branche CUDA principale d'Ampere ; le type de licence vGPU s'achète selon le scénario d'usage (chiffres officiels). Les versions logicielles évoluent, se référer aux publications officielles NVIDIA.
Achat et réception PROCUREMENT
Trois points d'inspection à l'achat d'une L40S :
Le référentiel complet des six tests de charge figure dans cette fiche « Comment tester en charge » de cette entrée.
Comment effectuer un stress test BENCH TEST
Six étapes de test, toutes les valeurs de jugement ancrées sur la L40S réelle : identification à l'ouverture → burn-in mono-carte (350W) → puissance FP8/INT8 → concurrence codecs → rendu graphique → burn-in longue durée.
Transport et livraison LOGISTICS
Fiches terminologie GLOSSARY
Carte double usage (rendu + IA)
Le positionnement produit de la L40S : capacités graphiques RT Core + inférence IA FP8 sur une même carte — la ferme de rendu calcule le jour et l'inférence la nuit, deux usages sur une machine (positionnement officiel).
Codec AV1
Standard de codage vidéo de nouvelle génération (à qualité égale, environ 30-50 % de débit en moins qu'H.264, consensus du secteur) : les 3×NVENC/3×NVDEC de la L40S intègrent tous AV1 — un atout pour réduire les coûts de bande passante en streaming et cloud gaming.
NEBS Level 3
Certification d'équipements télécom (Network Equipment-Building System) : tenue aux chocs, refroidissement et fiabilité aux standards des salles télécom — la certification NEBS Ready de la L40S lui ouvre les salles opérateurs (spécifications officielles).
Secure Boot with Root of Trust
Secure Boot à racine de confiance matérielle : vérification des signatures de firmware contre la falsification — socle de sécurité des environnements d'entreprise et du secteur public (spécifications officielles), l'état du Secure Boot figure au contrôle d'inspection.
Alimentation 16-pin
Nouvelle génération d'interface d'alimentation PCIe (famille spec CEM5) : 350W et plus sur un seul connecteur — les anciens blocs exigent un câble adaptateur conforme, dont la qualité est une variable cachée de la stabilité de la L40S.
Limites et controverses LIMITS
- Ni NVLink ni MIG : en multi-GPU, il s'agit de puissance de calcul juxtaposée et non d'un domaine d'interconnexion, sans possibilité de découpage multi-locataires — inadapté à l'entraînement, et un pooling multi-locataires moins efficace que les séries A/H (spécifications officielles [1]) ; ne vous trompez pas de cible lors du choix.
- Le plafond de bande passante du PCIe Gen4 : Gen4 x16, 64GB/s bidirectionnels — les charges d'inférence gourmandes en débit (roulement de grands KV cache) sont limitées par la bande passante hôte, seul un platforme Gen5 les libère (recompilation de cette base).
- Les câbles adaptateurs, sources de pannes cachées : la qualité des câbles 16-pin pour anciens blocs est inégale, échauffement en pleine charge et desserrage sont des causes fréquentes de retour SAV (expérience d'inspection de cette base) — câble d'origine et adaptation conforme sont le minimum.
- Le décalage de génération mémoire : GDDR6 à 864GB/s contre les plusieurs TB/s du HBM3e des séries H — l'écart est net en entraînement de grands modèles et KV cache très volumineux, le sweet spot de la L40S est l'inférence et le graphisme, pas l'entraînement.
- Variable des politiques transfrontalières : les cartes datacenter Ada figurent dans le périmètre des listes de contrôle des exportations (d'après les sources publiques) — la conformité des achats transfrontaliers relève d'un avis professionnel, cette base ne constitue pas un avis juridique.
Notes de marché MARKET NOTE
Le marché des L40S disponibles mélange neuves d'origine et cartes démontées de machines complètes, avec des écarts d'état et de canal — pas d'instantané de marché unifié vérifiable pour l'instant, Principe d'honnêteté de cette fiche : pas de bande de marché, le prix est soumis au devis réel du vendeur 。
Recherche des offres : AIXX Exchange Hall › (mise en relation sans commission, sans participation aux transactions, d'où la neutralité des données). Cette section passera à une bande de marché standard une fois les instantanés suffisamment accumulés.
Chronologie des jalons de prix MILESTONES
FAQ FAQ
Pour l'inférence et l'IA, la L40S : puissance FP8/INT8 doublée (733/1 466 contre 362/733 en sparse pour la L40), 350W contre 300W — l'écart de débit d'inférence dépasse l'écart de prix ; pour le rendu pur avec budget serré, la L40.
Après quantification, c'est jouable : environ 35-40 Go en INT4/FP8 pour 48 Go de VRAM, en limite (KV cache à doser finement) ; confortable avec deux cartes ; la version FP16 d'origine à 140 Go ne tient pas — le déploiement quantifié est l'approche dominante sur L40S.
Déconseillé : pas de NVLink (pas d'interconnexion multi-GPU), pas de MIG (pas de découpage possible) — il manque à la fois l'interconnexion et le partitionnement pour l'entraînement. La L40S cible l'inférence, le transcodage et le graphisme ; pour l'entraînement, voir les fiches A100/H100/B300.
Trois points : identifier via nvidia-smi une L40 déguisée en L40S (91,6 TFLOPS FP32 contre 90,5, 350 W contre 300 W), l'état du connecteur d'alimentation 16 broches et de l'adaptateur (cause fréquente de retour SAV), et un test réel d'encodage/décodage NVENC/AV1 (argument de vente clé pour le transcodage). Inspection visuelle du connecteur doré et de l'origine du dissipateur.
Il faut ajouter un ventilateur turbine : la L40S est une carte double slot passive (sans ventilateur), le flux d'air d'une workstation tour ne suffit pas pour évacuer 350 W en passif — un adaptateur de refroidissement actif ou un serveur rack est la bonne solution ; vérifier aussi l'alimentation 16 broches et un slot PCIe Gen4 x16.
Fiches liées SEE ALSO
Comparaison et choix de machines COMPARE
Références REFERENCES
- NVIDIA officiel — Spécifications L40S (cohérent point par point avec la fiche technique, données d'octobre 2026) https://www.nvidia.com/en-us/data-center/l40s/
- Site officiel NVIDIA — Page produit L40 (référence de la gamme) https://www.nvidia.com/en-us/data-center/l40/
- Recherche des ventes — AIXX Exchange (mise en relation sans commission ; pas d'instantané de marché pour la L40S, le prix réel est soumis au devis du vendeur) https://www.aixx.vip/hall.html?model=L40S